COBERTURA EXCLUSIVA 100% SEGURO.- La inteligencia artificial ya está siendo incorporada a distintos procesos de la industria aseguradora, pero pasar de una prueba de concepto a un agente capaz de intervenir en operaciones reales plantea un desafío diferente. En la gestión de siniestros, donde cada caso puede involucrar múltiples documentos, reglas, fuentes de información y decisiones sensibles, demostrar que un sistema funciona en algunos ejemplos no alcanza.
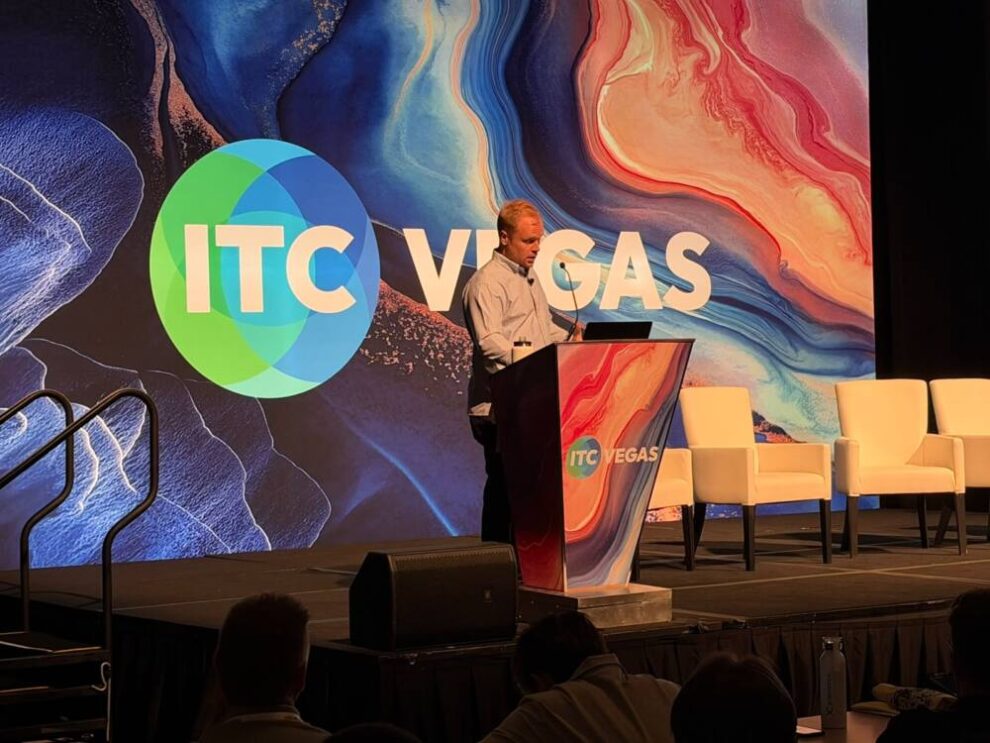
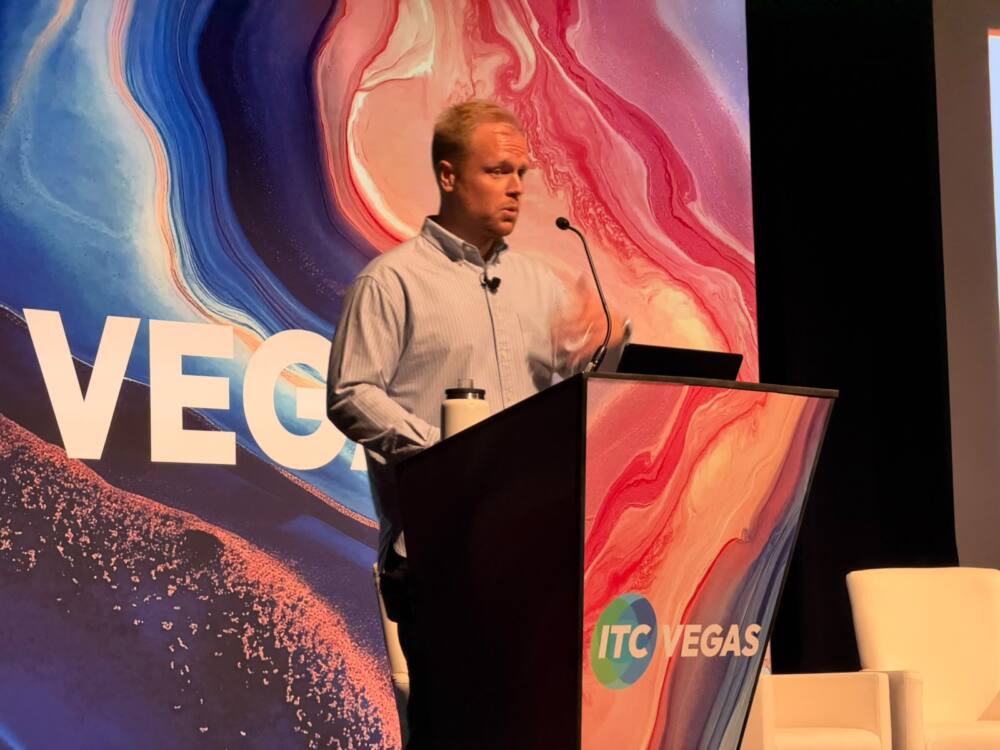
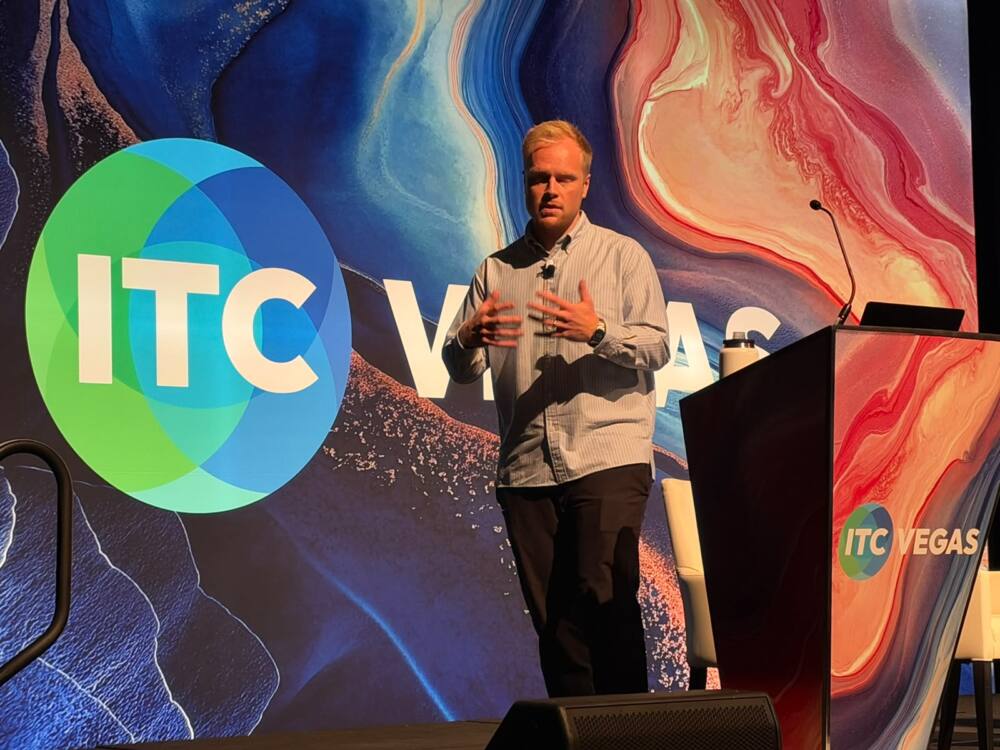
Ese fue uno de los principales ejes de la masterclass “Claims Agent Masterclass: How to Build an Agent You’d Trust with a Claim”, presentada en ITC Vegas 2026 por Tom Deaney, líder de IA aplicada para Seguros de Anthropic.
Con ocho años de experiencia en insurtech y seis dedicados al desarrollo e implementación de IA empresarial aplicada al seguro, Deaney trabajó durante la sesión sobre un caso concreto: la construcción de un agente capaz de asistir en la gestión de un siniestro, mostrando paso a paso qué información necesita, qué herramientas puede utilizar, dónde debe intervenir una persona y cómo evaluar si efectivamente está funcionando.
La conclusión que atraviesa toda la presentación es que construir un agente puede ser relativamente sencillo, aunque construir uno en el que una aseguradora pueda confiar requiere mucho más trabajo.
Un agente no es solamente un modelo de IA
Deaney explicó que un agente combina un modelo de lenguaje con herramientas que le permiten consultar información, ejecutar determinadas acciones y tomar decisiones dentro de ciertos límites. Pero, especialmente en una industria regulada, la arquitectura y los controles alrededor del modelo resultan tan importantes como su capacidad de razonamiento.
Una de las primeras distinciones que planteó fue entre el “cerebro” y las “manos” del agente. Mientras el modelo se ocupa de interpretar el contexto y decidir qué necesita hacer, las herramientas ejecutan las acciones concretas. Esta separación permite limitar el acceso del modelo a información sensible y reducir riesgos como la exposición de credenciales o determinadas formas de manipulación mediante los documentos que recibe. También permite mantener un registro de lo ocurrido.
“La trazabilidad es fundamental en un entorno regulado: debe ser posible reconstruir qué decisión tomó el agente, qué herramientas utilizó y qué información intervino en el proceso”, sostuvo Deaney.
Pero el desafío no termina en diseñar esa arquitectura. El verdadero problema aparece cuando hay que responder una pregunta mucho más sencilla: ¿cómo sabemos que el agente realmente funciona?
Un caso correcto no alcanza
Uno de los conceptos sobre los que más insistió el experto fueron las evaluaciones (evals). Que un agente haya procesado correctamente un siniestro no demuestra que pueda hacerlo de manera consistente.
“One claim isn’t anecdote”, planteó durante la demostración. Es decir, un único caso correcto no constituye evidencia suficiente. Incluso dos resultados acertados pueden ser producto de la casualidad. La confianza comienza a construirse cuando el agente es sometido a un conjunto representativo de casos en los que especialistas de la compañía ya definieron qué debería ocurrir.
Ese conjunto puede incluir el número de siniestro, los documentos de entrada, los resultados esperados, las desviaciones que deberían realizarse, niveles de investigación, tolerancias de reserva y otros criterios específicos de cada proceso.
Así, los evals se convierten en una especie de banco de pruebas permanente. Cada modificación del modelo, de las instrucciones, de las herramientas o del conocimiento incorporado al agente puede volver a evaluarse sobre ese conjunto para comprobar si realmente representa una mejora. Para Deaney, esta capacidad de evaluación debería comenzar a construirse cuanto antes.
“La única manera de tener confianza sobre los agentes de IA es someterlo a evaluaciones”, sostuvo.
Los métodos de evaluación pueden variar según la tarea. Algunos resultados admiten una comprobación directa de aprobación o rechazo; otros requieren verificar si el agente utilizó las herramientas adecuadas o siguió la estructura esperada. En casos más complejos, incluso puede ser necesario evaluar la respuesta generada frente a un resultado esperado utilizando otro modelo como instancia de evaluación. Pero el principio es el mismo: definir previamente qué significa hacer bien una tarea y medir al agente contra ese estándar.
De las SOPs al conocimiento operativo
El siguiente paso es darle al agente el conocimiento necesario para trabajar. En una aseguradora, buena parte de ese conocimiento ya existe: manuales de siniestros, procedimientos internos, criterios de escalamiento y documentación utilizada por los equipos.
Deaney propone transformar esas SOPs (Standard Operating Procedures) en skills: unidades de conocimiento operativo que puedan incorporarse al agente, actualizarse y reutilizarse.
“Se debe empezar con las SOPs y construir a partir de ahí”, resumió durante la sesión, de carácter técnico y a sala llena.
Sin embargo, advirtió, la documentación interna no necesariamente contiene todas las respuestas. Puede estar incompleta, desactualizada o cubrir solamente una parte de las situaciones que aparecen en la operación cotidiana.
Ahí vuelven a entrar en juego los evals. Si las pruebas muestran que el agente falla reiteradamente frente a determinados escenarios, esos casos permiten identificar qué conocimiento falta y ajustar el sistema. El proceso, entonces, deja de ser lineal. La documentación alimenta al agente, los casos de evaluación muestran sus puntos débiles, y esos resultados permiten modificar nuevamente el agente.
La IA puede decidir partes del proceso, pero no necesariamente el resultado final
Otro de los puntos centrales de la presentación fue el lugar que debe ocupar la IA dentro de una arquitectura aseguradora. Deaney planteó que, en procesos regulados, no necesariamente conviene entregar al agente la decisión final de aprobar o rechazar un siniestro. En cambio, puede utilizarse para resolver tareas específicas: analizar evidencia, identificar determinados riesgos, verificar información o generar un indicador que luego sea procesado por las reglas del sistema.
“La idea es mantener un núcleo determinista que gobierne las decisiones críticas, mientras el agente aporta capacidad de análisis en tareas concretas. Por ejemplo, un agente puede producir un determinado indicador de riesgo y el sistema de gestión de siniestros puede establecer que, a partir de cierto umbral, el caso debe ser derivado a una instancia específica”, ejemplificó.
Deaney explicó que este esquema permite mantener una lógica previsible: “Si se presenta la condición, el resultado es conocido”. Es decir, ante una determinada condición, el sistema sabe cuál será el resultado. Esta separación también reduce el impacto que podría tener una instrucción maliciosa incorporada dentro de un archivo o documento analizado por el agente.
Antes de producción: probar, comparar y supervisar
El especialista presentó un recorrido progresivo para llevar un agente desde las pruebas hasta la operación real. El primer paso es construir y validar los casos de evaluación. Para ello, destacó la necesidad de trabajar con especialistas que puedan definir qué significa un resultado correcto e incorporar tanto los casos habituales como los escenarios límite.
A partir de allí aparece el llamado holdout set, es decir, un conjunto de casos que se mantiene separado del proceso de mejora para comprobar si el agente puede responder correctamente ante situaciones que no utilizó durante su entrenamiento y ajuste. Después llega el shadow mode, etapa en la que el agente procesa información real en paralelo con el ajustador, pero no toma todavía la decisión. Su resultado puede compararse con lo que hizo el profesional frente al mismo caso.
Esa comparación también puede servir para descubrir nuevos escenarios que deberían incorporarse a las evaluaciones.
“Una discrepancia no implica necesariamente que el agente esté equivocado: puede revelar un caso que no estaba contemplado o incluso la necesidad de revisar el criterio utilizado por el equipo humano”, aclaró ante los asistentes.
El siguiente escalón es el draft: el agente comienza a generar una primera versión de una respuesta, recomendación o decisión, pero el ajustador continúa siendo responsable de aprobarla.
Recién después de atravesar esas etapas, y manteniendo mecanismos de supervisión, excepciones, niveles de confianza y eventualmente muestreos sobre los casos procesados, el agente puede asumir determinadas tareas en producción.
La progresión responde a una idea central de Deaney, y es que no se trata de pasar de una demo directamente a producción, sino de aumentar gradualmente el nivel de responsabilidad que se le asigna al agente a medida que existe evidencia sobre su desempeño.
El caso de una aseguradora: 12 semanas de trabajo
Para mostrar cómo este enfoque se traduce en un proyecto real, Deaney presentó el caso de una aseguradora que trabajó durante aproximadamente 12 semanas en un agente aplicado a decisiones complejas de cobertura.
El proyecto comenzó con la recopilación de los procedimientos existentes y la identificación de las herramientas internas necesarias para realizar las verificaciones correspondientes.
Luego se construyeron alrededor de 300 casos de evaluación a partir de siniestros reales anteriores. El trabajo con especialistas permitió identificar casos límite y situaciones que no estaban suficientemente contempladas en la documentación inicial.
Ese intercambio generó miles de comentarios y devoluciones que sirvieron para ajustar el agente y ampliar el conocimiento disponible para resolver los casos.
El proyecto llegó posteriormente a una instancia de shadow mode, en la que podían observar qué habría hecho el agente frente a casos reales antes de asignarle responsabilidad sobre esas decisiones.
Deaney señaló que, en este caso particular, estaban observando resultados que consideraban más precisos que los de los ajustadores humanos para esa tarea específica, debido a la complejidad del análisis y a la cantidad de documentos que debían ponderarse conjuntamente. “Se trata de un resultado observado en ese caso de uso y no de una conclusión general sobre la capacidad de la IA frente a los profesionales”, aclaró.
Más herramientas no siempre significan un mejor agente
La demostración también mostró cómo un agente puede consultar fuentes externas para complementar la información disponible internamente. Sin embargo, el ejecutivo de Anthropic puso el foco en que incorporar una nueva herramienta no es automáticamente positivo. Cada fuente adicional puede aportar información relevante, pero también sumar complejidad, tiempo de respuesta y nuevos permisos de acceso.
“El criterio debe ser qué información necesita realmente el agente para resolver una determinada tarea. La idea de fondo es otorgarle acceso a las herramientas necesarias, pero no más de lo necesario”, comentó.
En un proceso de siniestros, por ejemplo, una fuente externa puede aportar antecedentes que permitan generar un nuevo indicador de riesgo. Ese resultado puede volver luego al sistema core y utilizarse dentro de las reglas establecidas para definir si corresponde derivarlo. Nuevamente, el agente aporta inteligencia a una parte del proceso, mientras que la decisión crítica puede permanecer dentro de una estructura controlada.
La confianza como condición para escalar
Hacia el cierre, Deaney resumió el enfoque en tres acciones clave para las organizaciones que quieran avanzar con agentes de IA: hacer accesibles los sistemas y datos que los agentes necesitan, convertir las SOPs existentes en skills reutilizables y comenzar cuanto antes a construir una base de evaluaciones.
Sobre este último punto, reconoció que puede tratarse de un proceso largo y laborioso. Reunir cientos de casos, revisar sus resultados y asegurarse de que representan correctamente la operación requiere tiempo y participación de especialistas. Pero empezar con un conjunto reducido permite construir la capacidad necesaria para mejorar los agentes de manera sistemática. “Incluso 20 es mejor que nada”, señaló, al referirse a la necesidad de comenzar a reunir casos de evaluación.
El orador llegó a definir los evals como una parte fundamental del trabajo previo a la puesta en producción: “Si están perfectamente hechas, probablemente representan el 70% del trabajo de un agente”.
“El objetivo final no es simplemente desplegar un agente, sino generar un ciclo que permita ampliar progresivamente su alcance con evidencia sobre su desempeño”, ponderó el experto.
Para Deaney, un agente confiable en producción necesita tres elementos centrales: precisión, seguridad y gobernanza, y trazabilidad. Debe demostrar que funciona a escala, operar dentro de límites definidos y dejar un registro que permita reconstruir cómo se llegó a una determinada decisión.
En una industria como la aseguradora, donde las decisiones pueden tener consecuencias económicas, regulatorias y operativas, esa diferencia resulta fundamental. El desafío de la IA ya no pasa solamente por demostrar que puede hacer algo, sino por demostrar cuándo, cómo y bajo qué controles puede hacerlo de manera confiable.